Planejamento RTO e RPO na AWS: menos perda, mais resiliência

Gledyson Ferreira
@gledyson-ferreira
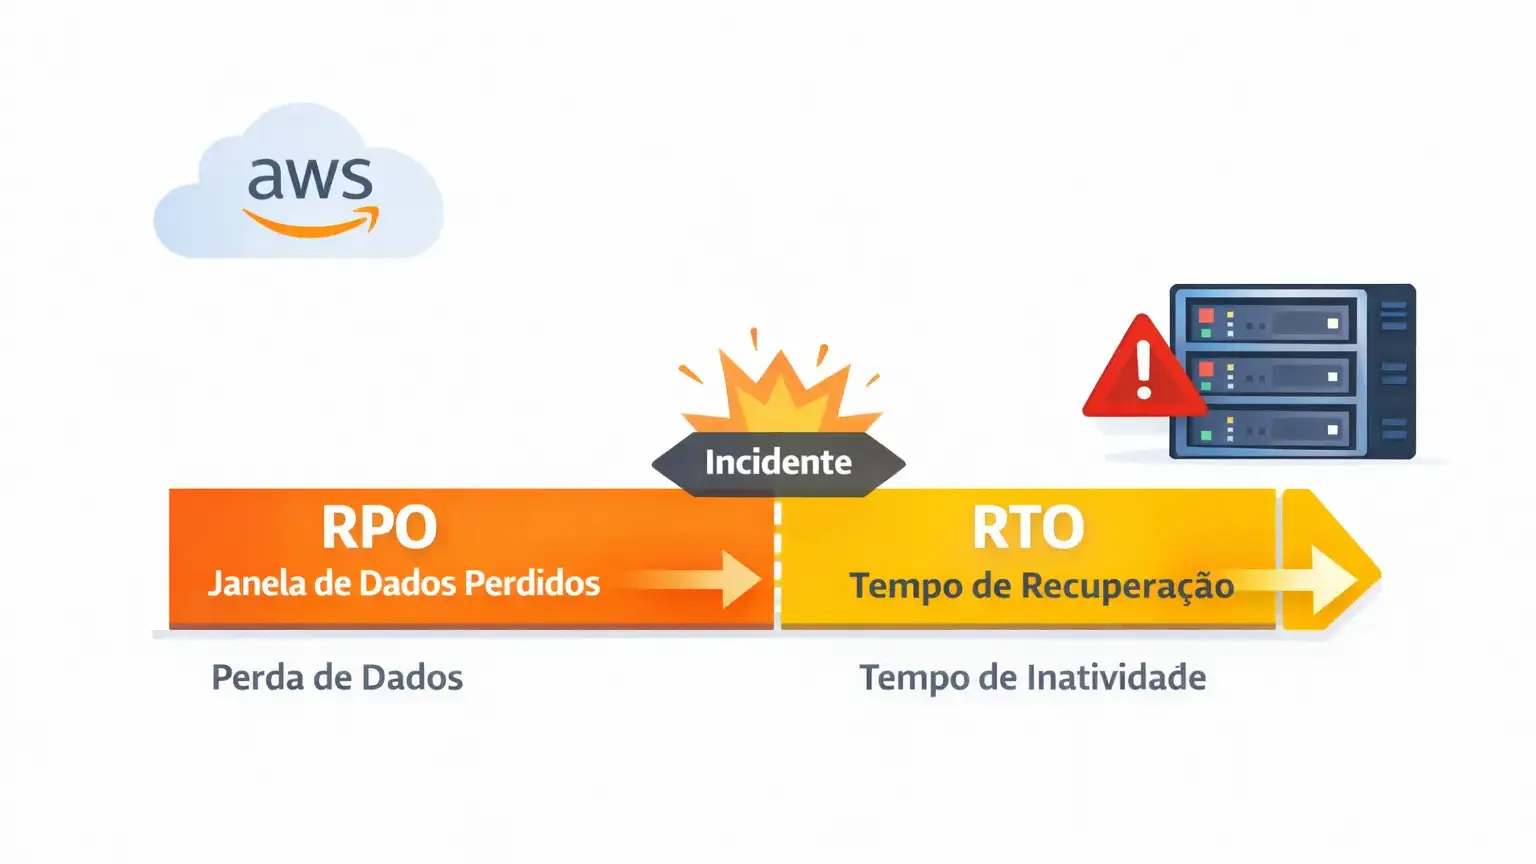
Planejamento de RTO/RPO na AWS
Em qualquer sistema em produção, desastres acontecem. Seja uma falha de hardware, um bug crítico ou até um desastre natural. Até provedores gigantescos de computação em nuvem como a AWS ou Cloudflare podem cair, como justamente aconteceu semanas atrás. Por isso, é essencial planejar quanto tempo e quanto dado estamos dispostos a perder quando algo der errado. É aí que entram os conceitos de RTO (Recovery Time Objective) e RPO (Recovery Point Objective), indicadores que definem metas de recuperação de serviço e de dados em caso de falhas. O RTO é o tempo máximo aceitável de indisponibilidade de um sistema após um incidente, enquanto o RPO é o intervalo máximo de dados (medido em tempo) que pode ser perdido nessa falha. Em outras palavras, RTO é sobre o tempo necessário para voltar ao ar, e RPO trata da quantidade de dados que podemos tolerar perder.
Em termos práticos, o RTO e o RPO são definidos com base em SLAs e análise de riscos. Por exemplo, aplicações críticas em geral demandam um RTO muito baixo, algo como 15 minutos, e um RPO próximo a zero para minimizar qualquer impacto. Já serviços menos sensíveis podem aceitar um RTO de algumas horas e um RPO com perda de algumas horas de dados. Essas metas guiam todo o plano de recuperação de desastres de cada aplicação.
Contudo, é importante balancear: reduzir RTO e RPO geralmente aumenta custos e complexidade. Recuperar uma aplicação em poucos minutos com perda quase nula de dados é ótimo, mas somente se o caso realmente exigir. Metas mais agressivas demandam recursos extras, como réplicas ativas em várias regiões e infraestrutura de standby, o que eleva custos operacionais. Portanto, cada aplicação deve ter seus objetivos de recuperação avaliados com cuidado, em diálogo com o negócio, considerando impactos financeiros, reputação e compliance.
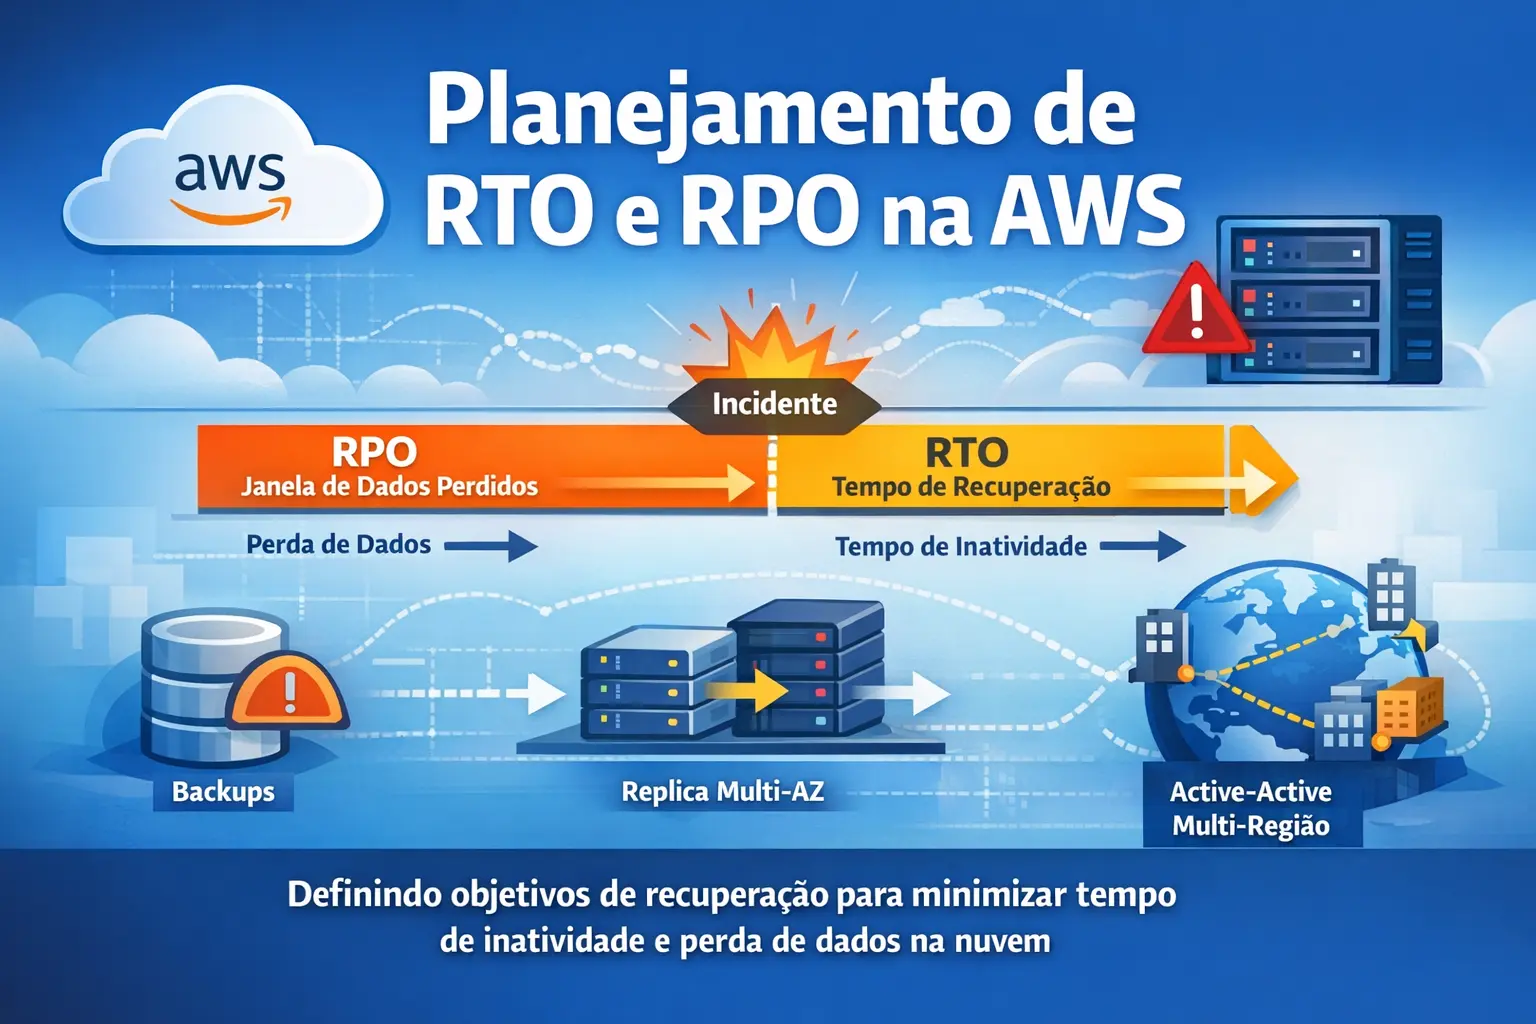
Conceitos: RTO e RPO na prática
O RTO, ou objetivo de tempo de recuperação, é o tempo máximo em que o serviço pode ficar indisponível após a falha, antes que isso cause prejuízo inaceitável. Já o RPO, ou objetivo de ponto de recuperação, é o intervalo de tempo máximo em que podemos perder dados, ou seja, quanto de dados estávamos dispostos a perder antes da última cópia válida.
Por exemplo, um RPO de 1 hora significa que só podemos perder dados dos últimos 60 minutos. Um RTO de 15 minutos significa que a aplicação deve voltar em até 15 minutos após a falha. Quanto menores esses valores, mais críticos e dispendiosos são os mecanismos de recuperação.
A AWS oferece serviços para ajudar a atingir essas metas. Ferramentas como o AWS Resilience Hub permitem definir políticas de resiliência e validar continuamente se os componentes da arquitetura cumprem os alvos definidos. Em última análise, RTO e RPO são medidas de resiliência de um sistema na nuvem. O RTO reflete a rapidez de restauração, e o RPO reflete a quantidade de dados que podemos repor.
Estratégias de recuperação na AWS
Ao planejar RTO e RPO na AWS, usamos uma combinação de serviços gerenciados e arquiteturas de recuperação. Abaixo explicamos algumas das abordagens mais comuns e como elas impactam os objetivos de recuperação.
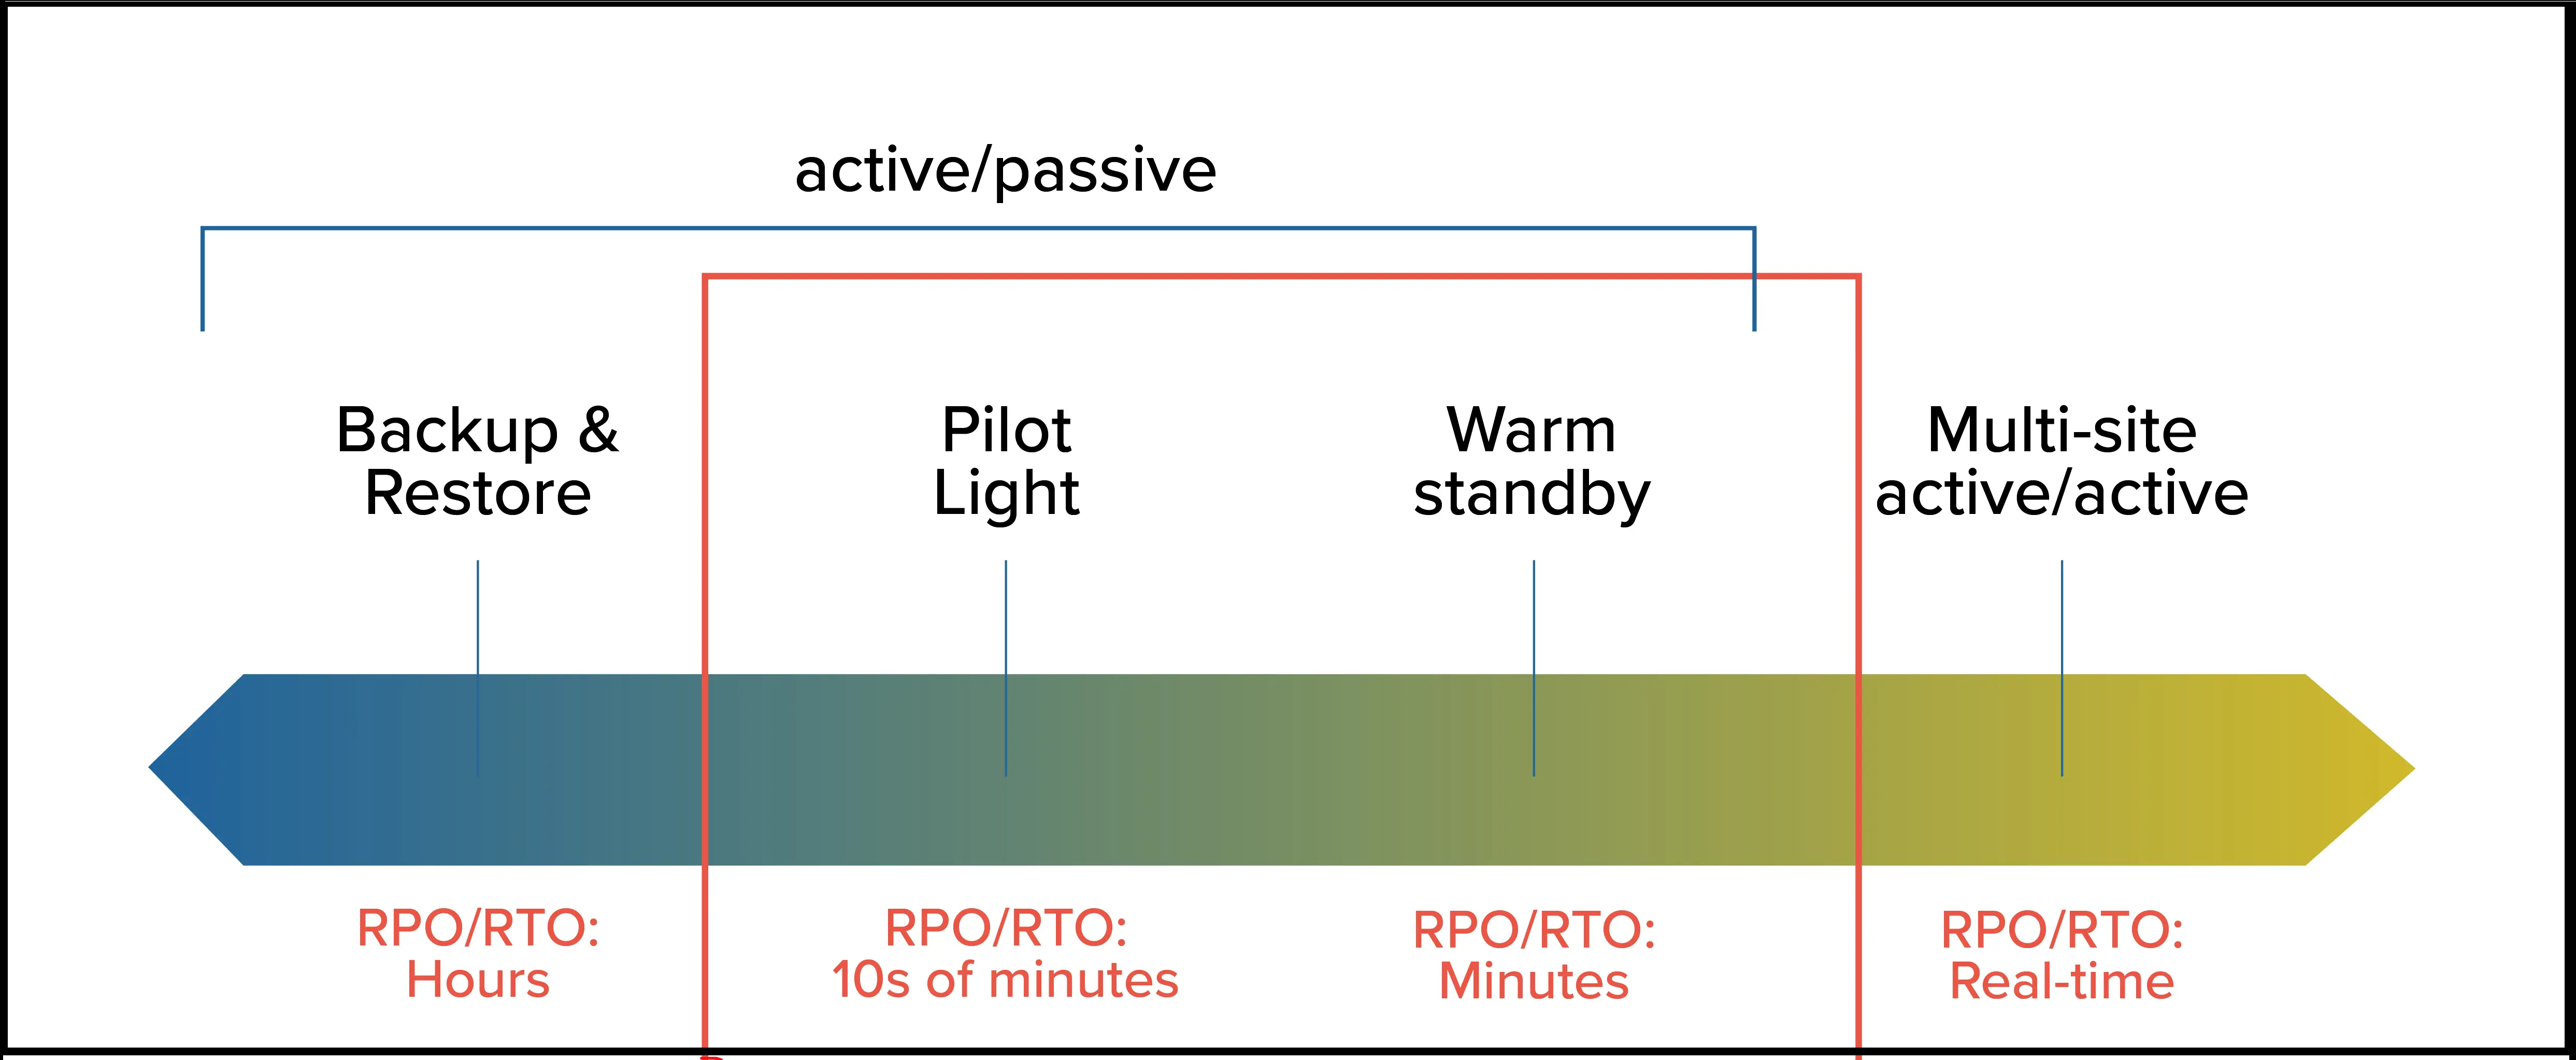
A estratégia de backup e restauração é a mais simples. Nesse modelo, replicamos dados com snapshots do RDS, EBS ou S3 para outra região. Em caso de falha, recriamos a infraestrutura com ferramentas como CloudFormation ou Terraform e restauramos os dados do backup. Essa abordagem costuma ter RTO alto, pois é preciso recriar tudo, e o RPO depende da frequência dos backups. Por exemplo, se os dados são copiados a cada hora, o RPO será de aproximadamente 1 hora.
O modelo pilot light mantém apenas a infraestrutura crítica desligada em um ambiente secundário. Os dados são replicados continuamente, pelo menos para o banco de dados. Em caso de desastre, essa infraestrutura mínima é ativada rapidamente. Isso resulta em um RPO baixo e um RTO médio, já que ligar recursos e escalar leva alguns minutos. Esse modelo tem custo mais baixo que manter tudo ativo o tempo todo.
A abordagem warm standby mantém um ambiente de recuperação parcialmente ativo em outra região ou zona de disponibilidade. Os serviços principais estão implantados, mas com capacidade reduzida. Em caso de falha, é possível escalar rapidamente esse ambiente. O RPO é baixo, graças à replicação ativa de dados, e o RTO também é reduzido.
Já o modelo multi-site active/active roda a aplicação simultaneamente em múltiplas regiões com tráfego distribuído. Toda requisição pode ser atendida por qualquer região. Isso garante RPO próximo de zero e RTO mínimo, mas é a opção de maior custo e complexidade, indicada apenas para sistemas muito críticos.
Dentro da AWS, vários recursos suportam essas estratégias. O Amazon RDS com configuração Multi-AZ, por exemplo, mantém uma réplica síncrona do banco de dados. Isso garante perda nula de dados e failover automático em cerca de 1 a 2 minutos. Para replicação entre regiões, o Aurora Global Database permite RPO de segundos. Já o DynamoDB com Global Tables ou o S3 com replicação entre regiões oferecem alta disponibilidade e perda quase nula de dados.
O uso de snapshots e backups contínuos também é essencial. No RDS, por exemplo, backups automáticos diários definem um RPO de até 24 horas. Com snapshots a cada 5 minutos, o RPO pode cair para 5 minutos. O AWS Backup permite agendar e centralizar essa gestão.
Além disso, utilizar infraestrutura como código (IaC) é uma forma de reduzir o RTO. Templates em CloudFormation, CDK ou Terraform permitem recriar toda a infraestrutura de forma automatizada e consistente, acelerando o processo de recuperação.
Por fim, testes e monitoramento contínuos são fundamentais. O AWS Resilience Hub permite simular falhas e avaliar se as metas de recuperação estão sendo atendidas.
Caso hipotético: e-commerce na AWS
Considere uma loja fictícia chamada Loja Online Acme. Sua arquitetura é composta por um front-end e APIs rodando em ECS Fargate, com um banco de dados MySQL no Amazon RDS. Avaliando três possíveis configurações, temos cenários diferentes para RTO e RPO:
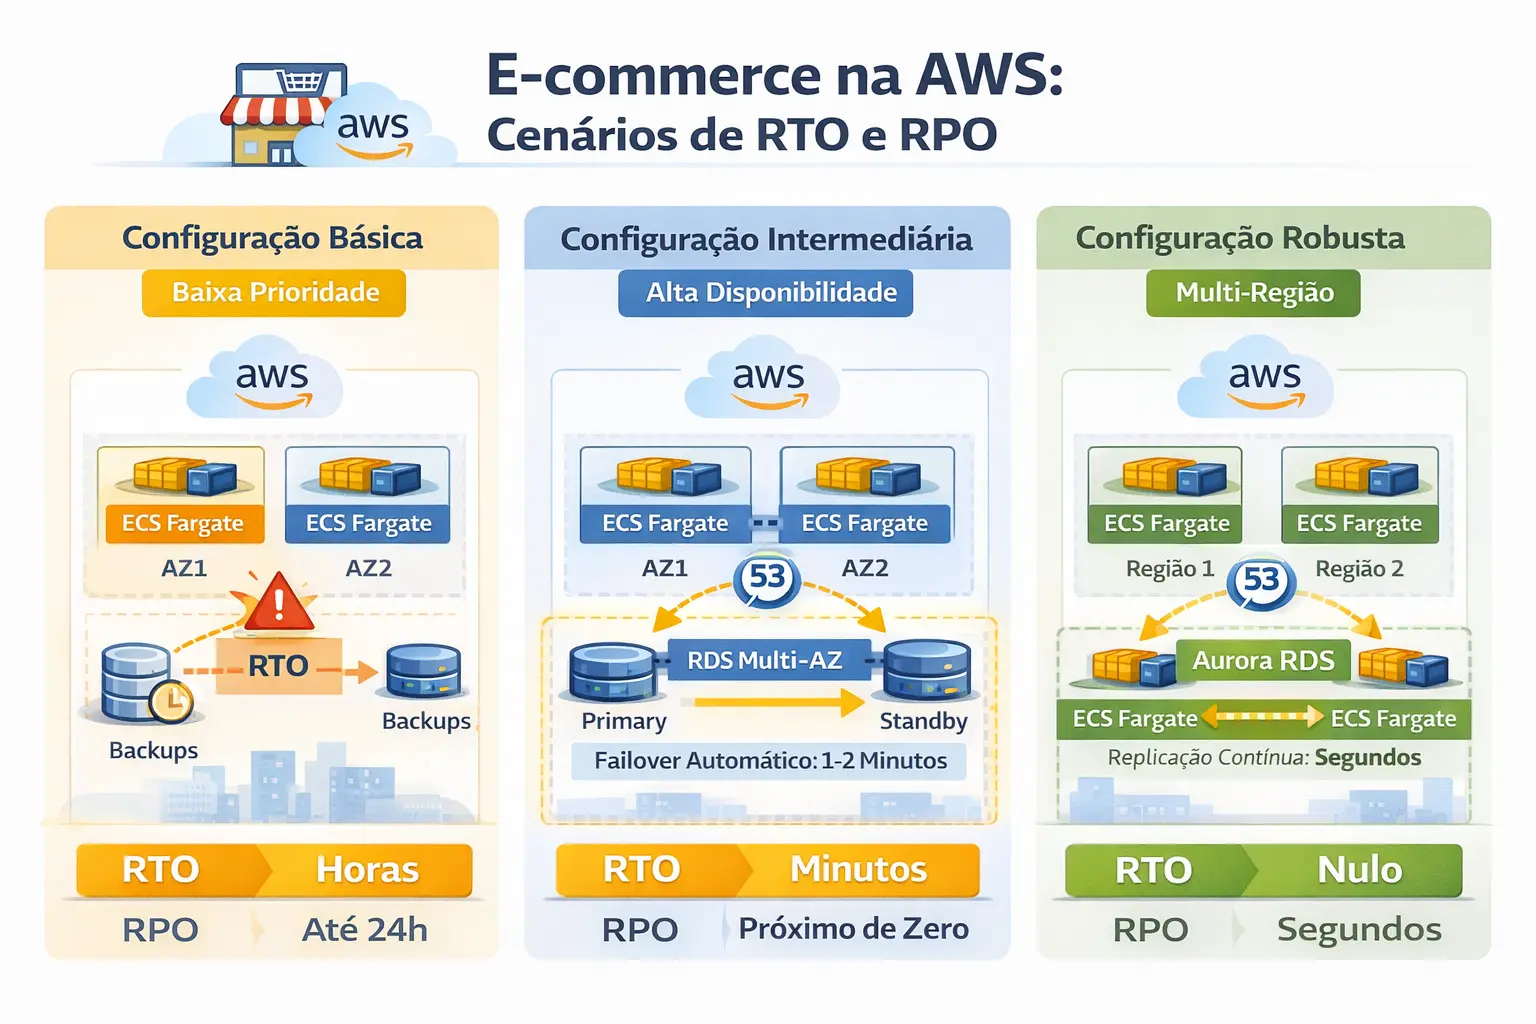
Na configuração básica, a aplicação está em uma única região e duas zonas de disponibilidade, com o RDS configurado como Single-AZ e backups diários. Nesse cenário, uma falha pode exigir reinstalar containers e restaurar o banco a partir do backup. O RTO é alto e o RPO também, com potencial perda de até 24 horas de dados. Esse modelo é adequado para aplicações de baixa prioridade.
Na configuração intermediária, com RDS Multi-AZ e ECS distribuído, a aplicação ganha resiliência. O RDS realiza failover automático em 1 a 2 minutos, e o ECS pode manter tarefas rodando em múltiplas zonas. Aqui o RTO é reduzido para poucos minutos e o RPO se aproxima de zero. Essa opção é adequada para sistemas com requisitos de alta disponibilidade.
Na configuração mais robusta, a Loja Acme opera em duas regiões com banco de dados replicado via Aurora Global Database e ECS rodando em ambas. Com o uso de Route 53 para redirecionamento automático e replicação contínua, o sistema suporta falha de uma região inteira sem interrupção visível. O RTO é praticamente nulo, e o RPO fica na casa dos segundos. Essa configuração atende a aplicações de missão crítica, mas exige maior investimento.
Conclusão
Planejar RTO e RPO é essencial para garantir continuidade de negócios e resiliência operacional. Na AWS, uma combinação de boas práticas, serviços gerenciados e automação permite atingir metas agressivas de recuperação. A escolha da estratégia depende do perfil da aplicação, da criticidade do serviço e do orçamento disponível.
Para aplicações críticas, soluções como Multi-AZ, replicação entre regiões e active/active são fundamentais. Para serviços menos sensíveis, backups regulares e infraestrutura como código já podem ser suficientes. O importante é definir objetivos realistas, alinhar com o negócio e testar periodicamente os planos de recuperação.
Referências
- https://aws.amazon.com/blogs/mt/establishing-rpo-and-rto-targets-for-cloud-applications/
- https://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/Concepts.MultiAZ.html
- https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/aurora-global-database.html
- https://aws.amazon.com/resilience-hub/
- https://aws.amazon.com/backup/
- https://docs.aws.amazon.com/whitepapers/latest/disaster-recovery-workloads-on-aws/disaster-recovery-options-in-the-cloud.html
- https://aws.amazon.com/architecture/well-architected/
- https://www.itexperts.com.br/blog/tecnico/recuperacao-desastres-aws/