Failover Multi-Cloud: A Resposta à Próxima Grande Falha?

Gledyson Ferreira
@gledyson-ferreira
Esta semana, a internet sentiu mais uma vez o impacto da centralização. Um outage significativo na AWS, originado por uma falha de DNS na onipresente região us-east-1, derrubou uma cascata de serviços e aplicações globalmente. Para muitas equipes de engenharia, foi um lembrete doloroso de que mesmo a infraestrutura mais robusta tem seus pontos de falha.
Eventos como este reacendem um debate crucial na arquitetura de sistemas: a dependência de um único provedor de nuvem é um risco aceitável? Se uma região pode falhar, um provedor inteiro também pode.
Nesse contexto, a estratégia de Failover Multi-Cloud surge como a fortaleza definitiva da resiliência. Mas essa fortaleza tem um custo. Vamos analisar o que é failover, como ele se aplica ao cenário multi-cloud, suas vantagens e suas complexas desvantagens.
O que é Failover?
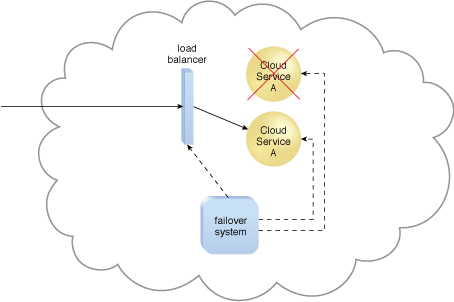
Em termos simples, failover é a capacidade de um sistema comutar automaticamente para um sistema ou componente de backup (standby) no momento em que o sistema primário falha. O objetivo é garantir a Alta Disponibilidade (HA) e a continuidade dos negócios, minimizando ou eliminando o tempo de inatividade (downtime) percebido pelo usuário.
Isso é diferente de um switchover, que é um processo manual e planejado (geralmente para manutenção). O failover é a resposta automática a um evento não planejado.
O Risco de um Ponto Único de Falha (SPOF)
A maioria das aplicações "nativas da nuvem" já é projetada para resiliência multi-AZ (entre Zonas de Disponibilidade). Muitas vão além, adotando uma arquitetura multi-região. No entanto, o recente outage da AWS expôs uma vulnerabilidade em um nível superior: falhas no "plano de controle".
Quando serviços fundamentais como DNS, IAM (Gerenciamento de Identidade e Acesso) ou o console de gerenciamento falham em uma região crítica como us-east-1, eles podem afetar operações globais, mesmo que suas aplicações estejam rodando perfeitamente em outra região.
Isso nos leva ao próximo nível de resiliência: se uma única região é um ponto de falha, o provedor inteiro também pode ser.
A Estratégia de Failover Multi-Cloud
O failover multi-cloud é uma arquitetura de alta disponibilidade que distribui a carga de trabalho ou mantém um backup em mais de um provedor de nuvem (por exemplo, AWS e Google Cloud, ou AWS e Azure).
A configuração mais comum é a Ativo-Passivo (Standby):
- Ativo: A aplicação principal roda integralmente na Nuvem A (ex: AWS).
- Passivo: Uma cópia exata (ou minimamente viável) da infraestrutura e dos dados está pronta na Nuvem B (ex: Azure), mas não recebe tráfego de produção.
Quando uma falha catastrófica é detectada na Nuvem A, o tráfego é automaticamente redirecionado para a Nuvem B, que se torna a nova ativa.
Como Implementar o Failover Multi-Cloud
Implementar essa estratégia é complexo e exige orquestração em três frentes principais:
1. O Ponto de Entrada: DNS Global e Health Checks
O componente mais crítico é o DNS. É ele quem decide para qual nuvem enviar o usuário.
- Serviços: São usados serviços de DNS globais que suportam failover baseado em health checks, como AWS Route 53, Google Cloud DNS, Azure DNS, ou provedores de CDN/DNS como Cloudflare e Akamai.
- Health Checks: O serviço de DNS monitora continuamente a "saúde" do endpoint primário na Nuvem A. Se múltiplos health checks falharem, o DNS automaticamente atualiza seus registros para apontar o domínio para o endereço IP do balanceador de carga na Nuvem B.
/* Exemplo conceitual de política de failover no AWS Route 53 */
{
  "RoutingPolicy": "Failover",
  "FailoverRecord": {
    "Type": "PRIMARY",
    "SetIdentifier": "primary-aws-endpoint"
  },
  "HealthCheckId": "health-check-id-aws"
}
{
  "RoutingPolicy": "Failover",
  "FailoverRecord": {
    "Type": "SECONDARY",
    "SetIdentifier": "secondary-azure-endpoint"
  },
  "HealthCheckId": "health-check-id-azure"
}
2. Sincronização de Dados
Este é, de longe, o maior desafio. A aplicação na Nuvem B é inútil se não tiver os dados dos usuários. A sincronização de bancos de dados exige replicação assíncrona contínua entre provedores (ex: AWS RDS para Azure SQL), o que pode ser complexo, caro e introduzir latência.
Similarmente, arquivos de storage como imagens e documentos precisam ser duplicados, exigindo ferramentas de mercado ou scripts customizados (via event streaming com Kafka/Pulsar, por exemplo) para sincronizar buckets (ex: S3 para Azure Blob Storage). Além disso, o estado de sessão geralmente é perdido no failover, exigindo que os usuários façam login novamente, a menos que um banco de dados global (como CockroachDB ou Spanner) seja usado.
3. Consistência de Aplicação e Infraestrutura
A aplicação deve ser capaz de rodar em ambos os ambientes. Kubernetes (K8s) é o grande facilitador aqui; usar clusters gerenciados (EKS na AWS, AKS no Azure, GKE no Google) com manifestos K8s padronizados permite que a mesma aplicação rode em qualquer nuvem.
Paralelamente, ferramentas agnósticas de Infraestrutura como Código (IaC) como o Terraform são essenciais. É impraticável gerenciar duas infraestruturas manualmente, e o Terraform permite definir a infraestrutura em ambos os provedores usando uma linguagem única.
Este artigo trás uma abordagem interessante de implementação do multi-cloud usando Terraform.
Vantagens do Failover Multi-Cloud
As vantagens são claras, começando pela Resiliência Máxima. É a proteção definitiva contra outages de larga escala, falhas de plano de controle, e até mesmo contra problemas contratuais ou de faturamento com um provedor. Isso leva à Redução do "Vendor Lock-in": embora não o elimine, manter a aplicação e a infraestrutura compatíveis com múltiplos provedores garante portabilidade e evita a dependência de serviços proprietários de uma única nuvem.
Finalmente, há o Poder de Negociação, pois a capacidade real de mover suas cargas de trabalho para um concorrente oferece uma vantagem significativa ao negociar custos.
As Duras Desvantagens (O Custo da Resiliência)
Antes de adotar o failover multi-cloud, é preciso encarar a realidade das suas desvantagens. A principal é a Complexidade Exponencial. Você não está gerenciando uma infraestrutura, mas duas, o que significa duplicar o gerenciamento de IAM, redes (VPCs, VNETs), monitoramento, logging e segurança, exigindo que a equipe seja proficiente em ambas as plataformas.
Segue-se o Custo Elevado, que se divide em dois problemas: a Infraestrutura Ociosa, pois você paga pelo standby na Nuvem B que fica 99.9% do tempo ocioso (no modelo Ativo-Passivo), e o Tráfego de Egress. Este último é o custo mais perigoso e oculto, pois provedores cobram caro pela saída de dados, e a sincronização contínua de bancos de dados e storage da Nuvem A para a Nuvem B pode gerar uma conta astronômica.
Também há a Latência de Sincronização, definida pelo RPO e RTO. O RPO (Recovery Point Objective) questiona quanta perda de dados você aceita; a replicação assíncrona sempre terá um atraso e, em um failover, os dados dos últimos segundos (ou minutos) podem ser perdidos. Já o RTO (Recovery Time Objective) define quanto tempo se leva para recuperar; o failover não é instantâneo, e a propagação de DNS (mesmo com TTLs baixos), a detecção do health check e o "aquecimento" da aplicação na Nuvem B (cold start) podem levar vários minutos.
Por fim, existe a Inconsistência de Serviços. O S3 da AWS não é 100% igual ao Azure Blob Storage, e o EKS não é 100% igual ao AKS. Pequenas diferenças em APIs, limites e comportamentos podem quebrar a aplicação no momento do failover, exigindo abstrações ou o uso do "mínimo denominador comum" de recursos.
Conclusão: Quando Faz Sentido?
O failover multi-cloud não é para todos. Posso dizer que pra mais de 90% das aplicações a abordagem multi-cloud será overkill. Em seu lugar, uma arquitetura multi-região robusta dentro de um único provedor (como AWS) oferece um equilíbrio muito melhor entre custo, complexidade e resiliência.
No entanto, o failover multi-cloud pode ser uma estratégia defensiva importante ou até essencial para:
- Sistemas de Missão Crítica: Serviços financeiros, processamento de pagamentos, sistemas de emergência ou qualquer negócio onde minutos de downtime representam perdas financeiras ou de reputação catastróficas.
- Requisitos Regulatórios: Setores que são legalmente obrigados a demonstrar planos de recuperação de desastres que incluem a falha total de um fornecedor.
O outage desta semana foi um alerta. Ele nos força a perguntar: "Qual é o nosso plano se o datacenter (ou a AWS inteira) desaparecer por uma hora?". Para algumas empresas, a resposta complexa e cara do "multi-cloud" é a única que garante o sono tranquilo.